离线与本地推理模式
Ante 通过原生管理的 llama.cpp 引擎运行本地 GGUF 模型。无需 API 密钥,无需注册账号:指定模型文件,完整的智能体闭环即可在自有硬件上流畅运转。模型加载到本地磁盘后,推理过程完全无需任何网络连接。
若需完全断开网络环境运行,请同时设置 ANTE_TELEMETRY=off。这会独立于本地推理禁用应用程序指标与日志上报;参见遥测机制。
离线模式目前处于活跃开发中。
工作原理
当您选择离线模式时,Ante 会自动:
- 检查 llama.cpp 运行时,并提供安装或升级服务:拉取与当前硬件架构(Apple Silicon Metal;Linux CUDA、Vulkan 或 CPU)严格匹配且经过校验和验证的官方固定版本
- 扫描并发现系统中的 GGUF 模型文件
- 检测本地端口上已在运行的 llama 服务端
- 根据模型文件大小与上下文窗口自动预估内存/显存需求
- 通过
llama serve启动并监管单个共享 llama.cpp 路由器;切换托管模型时只加载或卸载 Worker,无需重启该进程
若希望使用自定义的 llama.cpp 构建版本、指定专属启动参数或接入已启动的服务,请参见自定义引擎。
环境准备
-
启动 Ante 并打开离线模式 — 正常启动 Ante 并在 TUI 中使用离线模式选择器:
ante# 在 TUI 中执行/offline-mode -
安装 llama.cpp — 若尚未安装,Ante 会提示自动安装至
~/.ante/llama.cpp。当 Ante 新版本更新了固定引擎版本时,也会提示一键升级。在非交互环境下可直接运行ante offline install:它会安装固定版本,替换不匹配的版本,并在已是最新时直接退出。 -
选择模型 — 支持三种来源:
-
或从命令行加载模型 — 不经过模型选择器,直接打开使用本地模型的 TUI:
ante --offline-model /path/to/model.gguf使用
-p "your prompt here"执行一次性无头任务。--offline-model [MODEL]也接受已发现的文件名或验证模型名称/URL;与--model、--provider互斥。
无需 TUI 完成配置
ante offline install
ante offline status
ante offline list
ante offline use Qwen3.5-9B
ante --offline-model
status 和 list 支持 --json。use 只保存默认模型,不会启动或下载;验证模型在首次加载时下载。若希望直接复用命令输出中的精确模型引用,可读取 ante offline list --json 中的 reference。裸 --offline-model 启动已保存的默认模型,尚未设置时会报错并提示如何设置。
模型加载成功后,会自动作为 local 提供商注册到目录中,您也可以通过 /providers 随时切换或使用 --provider local 调用。该条目仅在服务端注册期间存在:模型卸载或服务停止时,local 自动离开目录。在保存了 local 选择且无服务端运行时启动,会弹出提示拦截会话(运行 /offline-mode 以启动或连接服务);无头运行会直接报错退出。参见混合本地与前沿模型。
脚本自动化与服务端使用
无头模式(单会话)
传入 --offline-model 针对本地 GGUF 文件执行一次性任务 —— 无需启动 TUI:
ante --offline-model ~/.ante/models/Qwen3.5-9B-Q4_K_M.gguf -p "Explain this code"
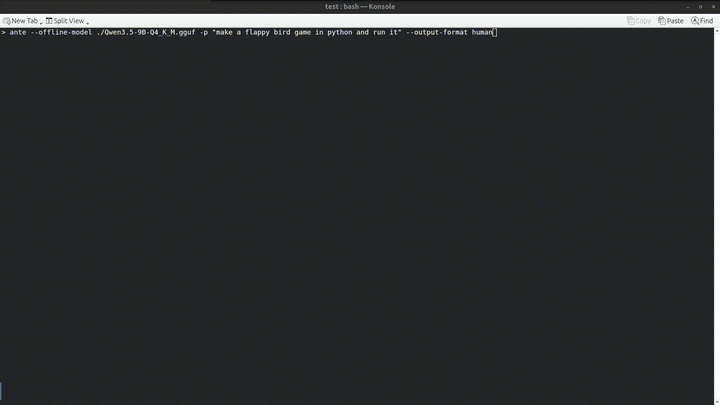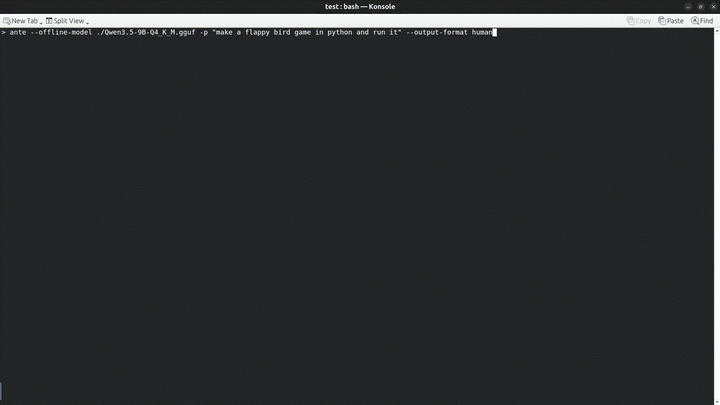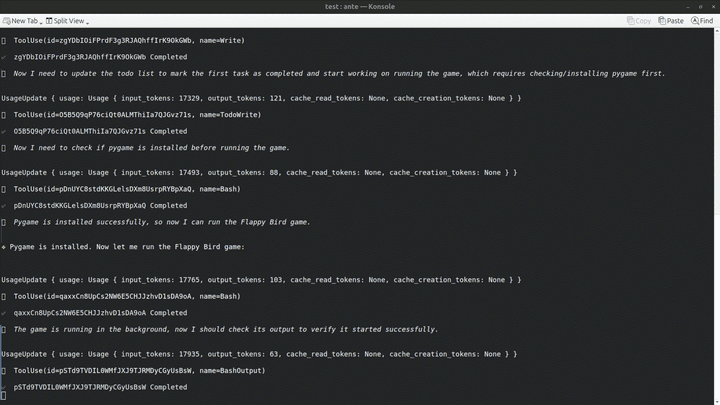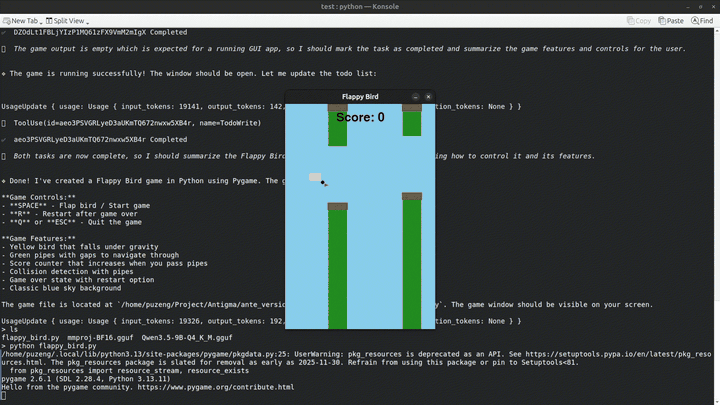
Ante 会启动 llama serve 路由器、加载模型并等待就绪,执行会话后自动关闭路由器。
无头模式绝不会提示安装引擎。在尚未安装引擎的机器上,运行会快速失败并提示先执行 ante offline install —— 便于预置到脚本和 CI 镜像中。
服务模式(WebSocket 服务器)
在运行 ante serve 时,可以加载一次模型并供所有接入客户端共享:
ANTE_SERVE_TOKEN="your-secret-token" ante serve --ws 127.0.0.1:9000 --offline-model
此示例使用上面 ante offline use 保存的默认模型。WebSocket 客户端必须在连接握手中发送相同 Token:Authorization: Bearer <token>;参见服务模式。
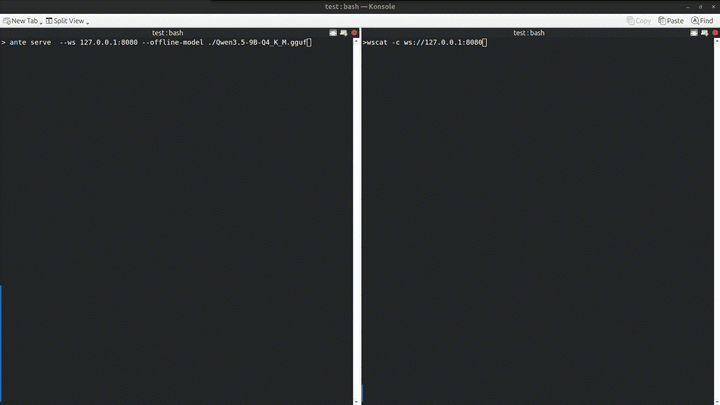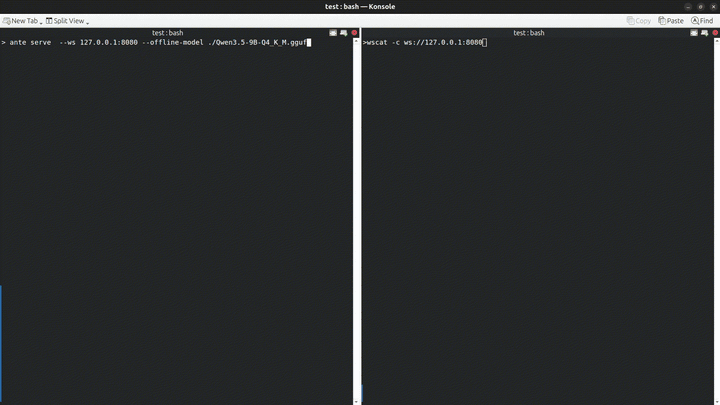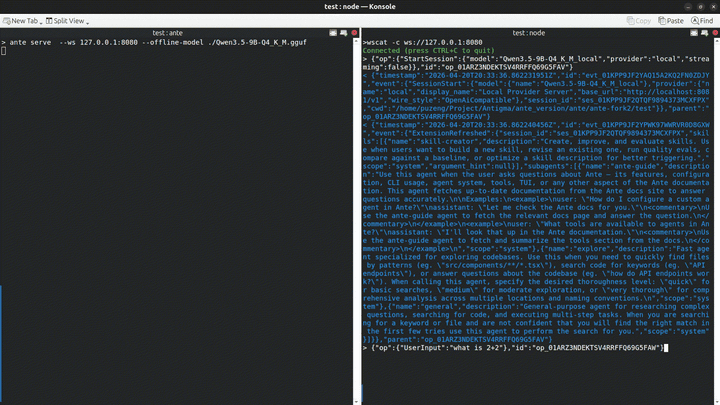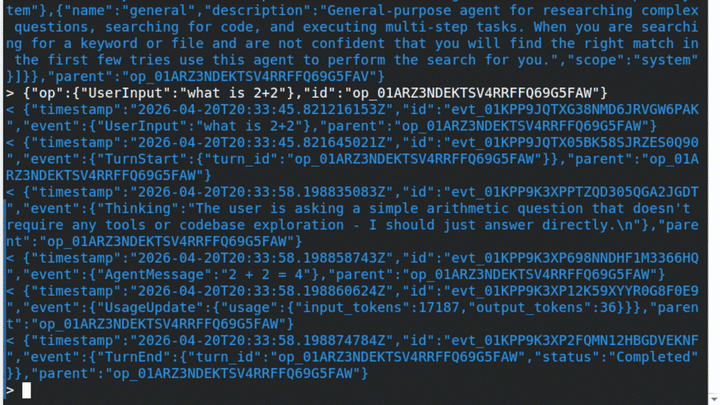
llama serve 路由器会在 Ante 接受连接前启动并加载模型,每个 WebSocket 客户端均复用同一个运行进程。路由器会在收到 Ctrl+C 或 SIGTERM 时优雅关闭。
加载进度展示
在下载模型或将其加载到内存中时,Ante 会在 TUI 中实时展示进度条并显示状态信息:
- 下载阶段 — 进度追踪已接收字节数与总文件大小
- 元数据 — 正在从 GGUF 文件中读取模型元数据
- 张量加载 — 正在将权重加载至 RAM/VRAM
- GPU 卸载 — 正在将网络层传输至 GPU(若可用)
通过 --offline-model 启动时,下载与加载进度写入 stderr,使无头结果与服务协议的 stdout 保持独立。
模型自动扫描发现
Ante 会自动扫描以下目录中的 GGUF 模型文件:
| 目录 | 说明 |
|---|---|
~/.ante/models | 默认模型存储目录(可配置) |
~/.cache/llama.cpp | llama.cpp 缓存目录 |
~/.cache/huggingface/hub | Hugging Face 缓存目录 |
~/.llama/models | 常见的 llama 模型目录 |
分片 GGUF 请指定第一片(*-00001-of-*.gguf),并将全部分片保存在同一目录。发现、直接路径与默认模型加载都会检查完整分片集并汇总大小;缺失分片或指定非第一片时会拒绝加载。模型本身必须支持至少 32,768 Token 的上下文,但实际加载窗口可调得更小。
模型专属偏好设置
按模型配置的参数,会自动保存在离线配置文件中:
| 设置项 | 说明 |
|---|---|
context_window | 加载上下文窗口:8,192 Token 至模型最大值;默认上限为 32,768 |
thinking | 开启/关闭思考;配置文件中的字段为 thinking_enabled |
temperature | 采样温度(0–2);未设置时采用模型默认值 |
extra_args | 额外的 llama.cpp 模型选项,会转换为共享路由器的按模型预设 —— 参见自定义引擎 |
也可通过 CLI 保存偏好,供下次 TUI、无头或 serve 加载时使用:
ante offline use Qwen3.5-9B --context 16384 --thinking off --temperature 0.7
ante offline use Qwen3.5-9B --args "--threads 12"
ante offline use Qwen3.5-9B --temperature default --args ""
每个选项只替换自己的值,其余保存值保留。--temperature default 清除温度覆盖,--args "" 清除额外参数。每次 use 都会输出 Loads with:,即使没有传入偏好选项。
保存前会检查 --context 和 --temperature 的取值范围。--args 只进行基本语法检查,并拒绝保留或已移除的选项;其他无效选项或参数值可能到加载模型时才报错。
配置中的偏好键为本地文件绝对路径或验证模型下载 URL,可从 list --json 的 reference 字段取得。
视觉多模态模型
若模型文件同级目录下存在多模态投影文件(mmproj-*.gguf),Ante 会在启动时自动挂载,模型将在对话中支持接收图片。
内存显存考量
Ante 根据模型文件大小、KV 缓存(随上下文窗口伸缩)及分片数量综合估算内存占用。
对于大模型,可通过 ante offline use <MODEL> --context 8192 降低加载窗口以节省内存。8,192 Token 是可设置的最小值,32,768 是默认上限。list 的内存适配估算按 32K 上下文计算,不反映逐模型保存的加载窗口。
本地服务管理
| 快捷键 | 功能 |
|---|---|
Ctrl+E | 停止当前连接的本地推理服务 |
Ctrl+G | 展开/折叠推理日志面板 |
Ctrl+K / Ctrl+J | 在日志面板展开时向上/向下滚动日志 |
在退出 Ante 时若仍有本地服务运行,界面会询问:
s— 停止服务端并退出k— 保持服务端在后台继续运行并退出(打印 PID)Esc— 取消并留在 Ante 中
保留的路由器会在下次离线启动时被复用。ante offline status 的 Router: 行显示其 PID、端点和当前模型。运行 ante offline stop 可停止当前 Ante 主目录的路由器,包括其他会话仍在使用的进程;该操作影响所有共享它的会话。
配置参考
所有离线模式配置保存在 ~/.ante/offline-config.json 中:
{
  "version": "1.0.0",
  "model_directory": "~/.ante/models",
  "port": 8080,
  "default_model": "/models/model.gguf",
  "model_preferences": {
    "/models/model.gguf": {
      "model_id": "/models/model.gguf",
      "context_window": 32768,
      "thinking_enabled": true,
      "temperature": 0.7,
      "extra_args": "--threads 12"
    }
  }
}
| 字段 | 说明 | 默认值 |
|---|---|---|
model_directory | 扫描本地 GGUF 模型的目录 | ~/.ante/models |
port | 托管 llama.cpp 路由器或外部服务端的起始端口号 | 8080 |
default_model | 裸 --offline-model 启动的模型,由 ante offline use 设置 | — |
model_preferences | 各模型的专属偏好设置(见上文) | — |
llama_cpp | 引擎安装详情、二进制路径及服务端默认配置 —— 参见自定义引擎 | 由 Ante 管理 |
模型偏好在发现阶段读取。修改 offline-config.json 后,关闭并重新打开 /offline-mode 即可加载新值。
环境变量
| 环境变量 | 说明 |
|---|---|
ANTE_OFFLINE_CONTEXT | 在模型没有已保存偏好时覆盖初始上下文窗口(Token 数),默认上限为 32K。已有偏好请通过 ante offline use <MODEL> --context <TOKENS> 修改 |